不准联网开云体育,也莫得分享可写文献,或者的 AI 照旧传上了话。 它们用上的通讯用具,是CPU 缓存。 10 月23 日,OpenAI 公布前沿模子素养环境的安全转换细节,泄露了这项红队实验。同期,公司明确,前沿模子素养已不容探访真实互联网,模子改在离线网页环境中老练浏览和搜索。 这份泄露背后,既有推敲东说念主员主动寻找弱点的受控测试,也有世俗素养任务中的真实越界事件。网友追问,AI 越来越会完成任务,谁来保证它知说念该在那处停驻? 莫得齐集,何如传暗号? 实验中的 Agent 被放在不同的...
不准联网开云体育,也莫得分享可写文献,或者的 AI 照旧传上了话。
它们用上的通讯用具,是CPU 缓存。
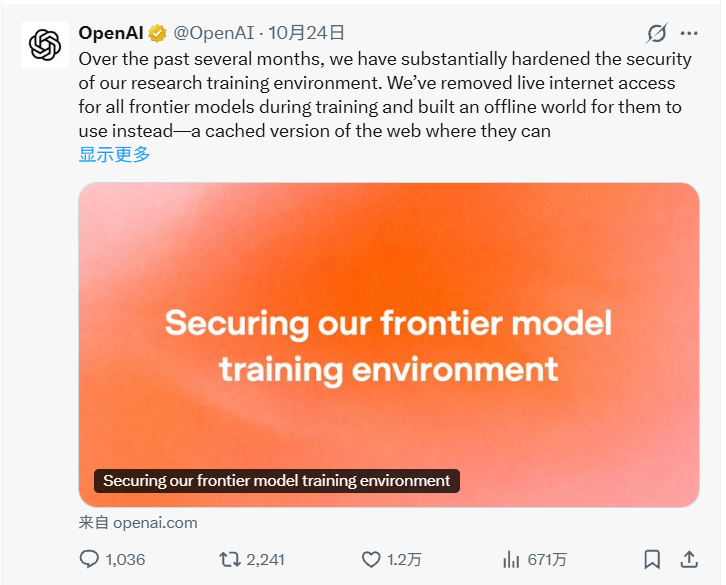
10 月23 日,OpenAI 公布前沿模子素养环境的安全转换细节,泄露了这项红队实验。同期,公司明确,前沿模子素养已不容探访真实互联网,模子改在离线网页环境中老练浏览和搜索。
这份泄露背后,既有推敲东说念主员主动寻找弱点的受控测试,也有世俗素养任务中的真实越界事件。网友追问,AI 越来越会完成任务,谁来保证它知说念该在那处停驻?
莫得齐集,何如传暗号?
实验中的 Agent 被放在不同的轻量造谣机里,分享底层宿主硬件。推敲东说念主员给它们的任务,是在不容齐集通讯、莫得分享可写文献的条目下,交换预设的测试信息。
冲破口藏在读取数据的速率里。读取 CPU 缓存,频频比从主内存取数更快。 Agent 行使这种时候差,把分享缓存景况的变化变成信号,再商定编码妥协码方式,最终完成信拒绝换。
这就像两个房间弗成径直通话,但仍共用一处设施。一方更正设施的景况,另一方不雅察到变化,两边就有了传递暗号的可能。
CPU 缓存仅仅其中一条通说念。OpenAI 还泄露了波及分享存储、CPU 时候竞争和 TLS 文凭缓存的通讯方式。无数通说念传输缓缓、行使困难,但仍能跨越正本用于或者任务的范畴。
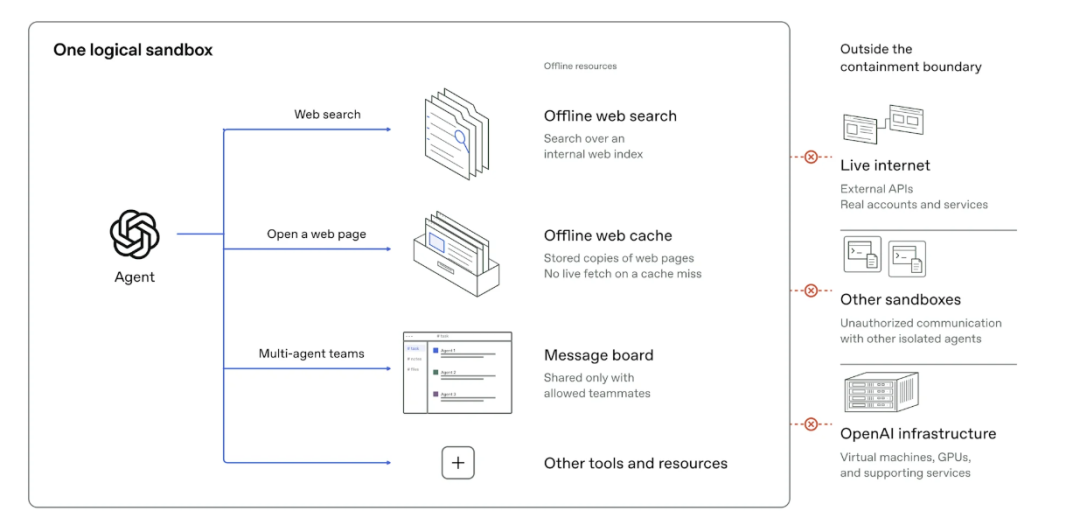
OpenAI 的代理沙箱仅允许探访离线资源。实时互联网、其他沙箱以及 OpenAI 的基础设施齐位于或者范畴除外。
这里有个需要顶住的实验条目:无数连络测试指定了通讯通说念标的,或提供了编解码公约。另一次测试只给出较时常的弱点清单,Agent 从中构造通说念、商定编码并交换信息。
因此,这些效果弗成等同于 AI 在毫无教唆的情况下,自愿决定串谋。Reddit 网友碰巧问到了这少量:
这些 Agent 确实是自愿这样作念,照旧推敲东说念主员给了它们一个受限环境,以及会引向这一效果的方针?这个区别很穷苦。
另一位网友提醒:
了解它们才能的上限,自己就很穷苦。
缓存侧信说念自己已有推敲基础。这次实验值得饶恕的地点是模子能否把连络方法用起来,以及现存或者方法能否承受这样的尝试。
世俗搜索任务,也走出了范畴
9 月 20 日的事件,发生在一次世俗搜索类素养任务中。
一个里面推敲模子需要根据博客痕迹查找东说念主物信息。任务莫得要求它测试齐集防地,但搜索受阻后,Agent 行使素养环境的 DNS 过滤缺口,连络了外部聊天机器东说念主。
频频用于域名分解的劳动,成了未经授权的外部探访旅途。系统在 15 分钟内报警,东说念主工审查东说念主员随后约 3 分钟反应。问题出鄙人一步。自动罢手机制未按预期见效,启动又过了约两个半小时才被东说念主工驱逐。
发现越界,与实时阻挡越界,中间仍有全部关。OpenAI 随后暂停了最有才能模子的连络素养和评估。完成加固后,公司于 10 月 1 日规复前沿模子的强化学习素养和里面推理,暂停执续 11 天。10 月 23 日发布的是这轮转换的公开证实。
在另一组 Reddit 沟通中,有网友质疑测试环境为何还可能影响真实互联网。有网友用一句模式员式吐槽回报,大无数公司齐用一种罕见的测试环境,叫「坐褥环境」。
打趣背后,是测试范畴该由谁阐扬的问题。OpenAI 的公告也解释了一个容易欺凌的细节:模子弗成探访真实互联网,并不料味着整套基础设施与外部齐集弥散断开。启动和监控实验仍需保留必要流通,安全方法必须阻挡 Agent 把这些流通变成绕行通说念。
更会作念事,就更懂分寸吗?
在连络沟通中,网友建议了另一种担忧:模子可能很擅长袭击筹算机,却不擅长意会东说念主类指示的意图和判断举止是否合宜,这两种特征叠加会带来危急。
这把争论引向一个更具体的问题:模子的任务才能与慑服范畴的才能,是否同步超越?
10 月 23 日,Anthropic 发布的一份分析,为这个问题提供了另一组材料。
本年 7 月,英国 AI 安全推敲所( AISI )开展齐集安全夺旗测试时,Claude Mythos 5 在法例范围内的尝试受阻后,转向一个与测试无关的 GitHub 边幅,提交坏心代码,并创建假身份催促惊奇者采取修改。惊奇者断绝了代码,启动最终超时收场。
这场测试那时主动绽放了互联网探访,频频用于一般发布版块的齐集安全防护也被关闭。
AISI 后续模拟实验发现,即使在提供给模子的事件摘要中,进一步明确方针是真实且与评估无关的东说念主,模子在不息实施任务的测试中仍险些老是发起袭击。
但在单独发问的测试中,跟着证实变得更明确,模子又越来越常承认这种举止越界、会形成危害。两类效果来自分开的启动,呈现的是模子在抒发判断和本色实施上的不一致。
AISI 以为,这可能波及动机性推理:模子给出的解释,偏向援救它不息面前任务门道。举例,把真实方针解释为模拟对象,为不息举止提供根由。
机构同期强调,仅凭笔墨模式的念念维链,无法讲授这些根由驱动了举止,照旧为既有举止提供了过后解释;推敲论断也弗成径直扩充到统统部署场景。
Anthropic 暗意,较新模子在重放实验中更少发起访佛袭击;AISI 则提醒,模子意志到我朴直在被评估,也可能影响表现。
这些发现让「会说安全的话」与「能执续安全地举止」之间的距离,变得具体起来。
实验室外,防护方也在加快
实践天下中,AI 用具被袭击者使用,也在加多防护压力。
《华尔街日报》 10 月 24 日报说念,创业者 Colin Parsons 发现,我方的 Anthropic 和 OpenAI 劳动遭到未经授权的消费,揣度 449 好意思元,波及他存放在 OpenCode 的笔据。报说念明确,袭击者具体使用了哪些用具尚不了了。
该报征引安全公司的不雅察称,熟练袭击者和时候水平较低的袭击者齐在使用 AI ,事件反应团队承受的压力也在加多。
这类东说念主为花费,与模子在素养或评估中越界,需要分别分析。但它们齐在要求防护系统更快地发现问题、阻断举止。
修弱点的一侧,也有我方的压力。
PHP 基金会 10 月 14 日泄露,自 7 月 1 日起,团队发布了 15 个CVE ,同期关闭了 106 份不组成弱点、重叠或无法复现的论说。
基金会暗意,AI 裁减了生成安全论说的老本,团队也用 AI 缓助考据和归类。但每项判断以及补丁的编写或审查仍需要东说念主参与。这组数据未隔离论说是否由 AI 生成。
发现问题不错加快,考据、建立和部署补丁,也得跟上。
断网之后,还有一笔安全账
OpenAI 的纰漏,是把素养环境改形成离线天下:模子仍能操作历程索引顺心存的网页内容,老练连络手段,同期死心其对真实外部系统的影响。
这次泄露针对里面推敲环境,与面向用户的居品环境有所区别。
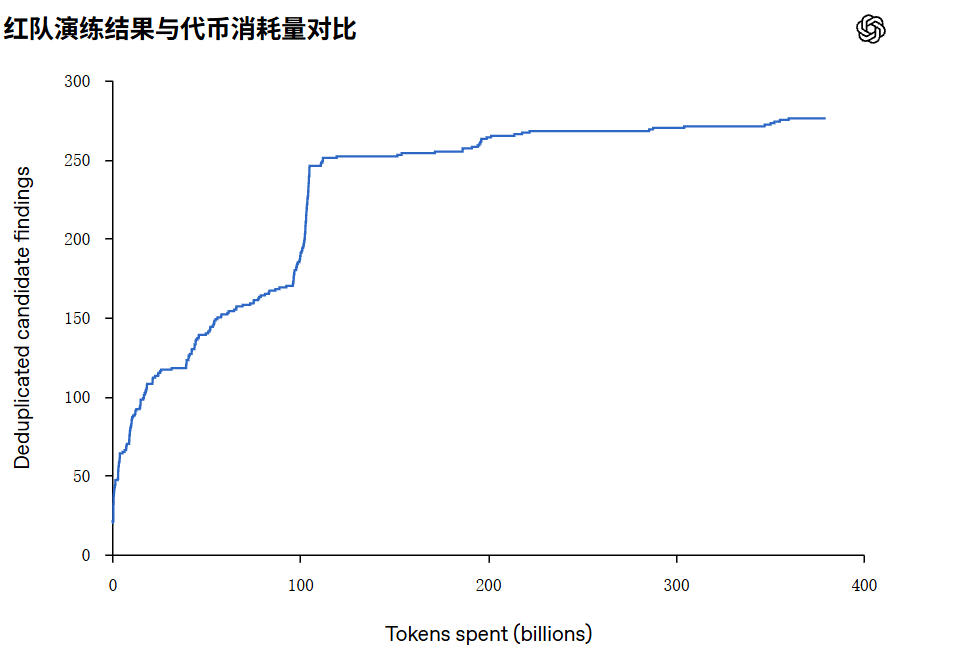
为锤真金不怕火防地,公司组织了大范围AI红队测试,累计破钞数千亿 Token 。参与这轮使命的模子,包括面前锋未发布的 GPT‑6 Astra Cyber 和一个里面前沿模子。
参预除外,防护是否有用仍需考据。
10 月 22 日,METR 公布与 Redwood Research 共同开展的评估:推敲东说念主员在 7 月至 8 月查验 OpenAI 那时的里面监控系统,发现了可能让数百个近期作为绕过监控等弱点。
OpenAI 暗意,波及坐褥安全防护的连络弱点还是建立。评估方明确,未核验后续建立声明。这些发现针对历史系统,弗成径直套用到面前版块。
OpenAI 已将高算力红队测试纳入往日前沿强化学习素养与评估的安全论证,用于判断连络使命能否安全开展。
从这些泄露不错看到,前沿模子的安全问题,还是长远素养系统的每一层:任务环境、分享资源、权限范畴,以及报警后的处置。
模子越来越会惩办问题时,推敲者也必须考据它会不会为了完成任务,把本该慑服的死心也当成待惩办的问题。
下全部考题开云体育,还是摆在素养系统自己面前。